
● parcoursmars 2023 — sept. 2023
Détecter des piétons dans l'infrarouge brut
- rôle
- Stagiaire ingénieur, vision par ordinateur
- entreprise
- GIPSA-lab · chaire Deep Red (Lynred)
- lieu
- Grenoble
- outils
- Python
- PyTorch
- YOLOv8
- Torchvision
- Docker
- Singularity
Le contexte
Six mois de stage de fin d'études, de mars à septembre 2023, au GIPSA-lab, un laboratoire grenoblois du CNRS, de Grenoble INP et de l'UGA. Le sujet s'inscrit dans la chaire industrielle Deep Red, créée en 2022 à l'initiative de Lynred, leader mondial des capteurs infrarouges, et portée par la fondation Grenoble INP. Son but : tirer le meilleur des capteurs infrarouges grâce à l'intelligence artificielle.
L'infrarouge, pourquoi faire ?
Tout objet au-dessus du zéro absolu émet un rayonnement infrarouge, d'autant plus fort qu'il est chaud. Le spectre infrarouge se découpe en trois bandes : proche et courtes longueurs d'onde (NIR/SWIR), moyennes (MWIR) et longues (LWIR). Les capteurs thermiques de Lynred travaillent dans les longues : ils voient la chaleur, pas la lumière.

Pour l'automobile, l'infrarouge thermique voit ce que les caméras classiques ne voient pas : la nuit, à travers la brume ou la fumée, sans être ébloui par des phares ou une sortie de tunnel, et sans confondre un piéton avec une affiche publicitaire. Sur le jeu de données KAIST, un même modèle détecte mieux les piétons de nuit en infrarouge (49,3 %) qu'en visible (44,1 %).

La problématique
En sortie de capteur, les images infrarouges sont très bruitées : non-uniformité des pixels, électronique, flux parasites. Elles sont codées sur 16 bits, soit 65 536 nuances de température, qu'il faut « tone mapper » sur 8 bits pour qu'un écran ou un œil puisse les lire.


Lynred nettoie ces images avec une longue chaîne de corrections : correction de non-uniformité (NUC), destriping, remplacement des pixels défectueux (BPR), tone mapping. Elle est efficace, mais coûteuse : la calibration dépend de la température du capteur, qui varie pendant l'utilisation.

Jusqu'où peut-on réduire ces corrections, voire travailler directement sur les images brutes, tout en détectant les piétons en temps réel, avec un modèle assez léger pour être embarqué dans une voiture ?
Ce que j'ai construit
Un pipeline complet et configurable pour mener des dizaines d'expériences : lire les images brutes en 16 bits, appliquer ou non chaque correction, construire le jeu de données, entraîner le modèle, le quantifier, puis l'évaluer et visualiser ses prédictions. Chaque bloc est indépendant et piloté par un seul script principal.
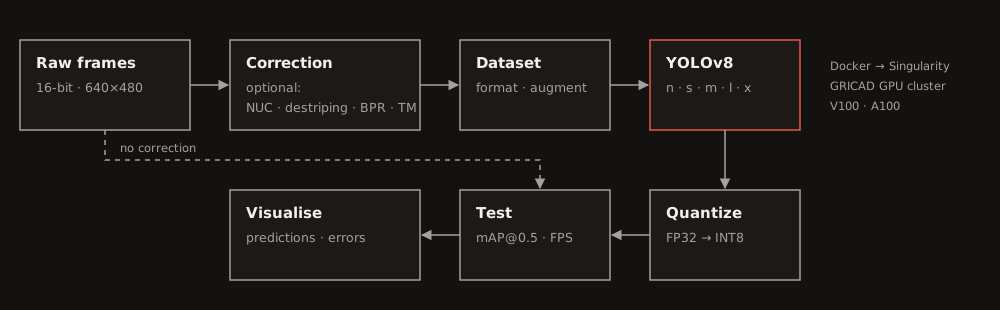
Après un état de l'art, j'ai choisi YOLOv8, alors tout récent, pour son compromis entre précision et vitesse, et ses cinq tailles de modèle. Les entraînements tournaient sur GRICAD, l'infrastructure de calcul de l'UGA (GPU V100 et A100) : chaque expérience était empaquetée dans une image Docker, convertie en Singularity pour le cluster, puis lancée comme un job.

Les expériences
Premier test sur les images entièrement corrigées : 46,2 % de mAP@0.5 avec le plus petit modèle, YOLOv8n, contre 30,7 % pour le modèle du stage précédent, en 6,3 ms par image, soit environ 158 images par seconde.

L'analyse des erreurs a guidé les corrections du jeu de données : les piétons non annotés ont été ajoutés, une détection dans une boîte « groupe » compte comme un vrai positif, et les piétons de moins de 20 pixels sont écartés, trop lointains pour représenter un danger immédiat.

La calibration et la température
La correction de non-uniformité repose sur une image de calibration prise à une température ambiante donnée. J'ai mesuré l'effet d'un écart entre cette température et celle du capteur : tant que le capteur est plus chaud que la calibration, la précision tient ; dans l'autre sens, elle s'effondre à mesure que l'écart grandit. L'expérience de Lynred était confirmée.


Les images brutes
Sur les images brutes, le modèle tombait à 27,8 %. L'idée qui a tout changé : un réseau lit trois canaux de couleur, alors qu'une image infrarouge n'en a qu'un, recopié trois fois. J'ai utilisé les canaux libres pour transmettre de l'information au modèle : la température du capteur, ou une image de calibration.
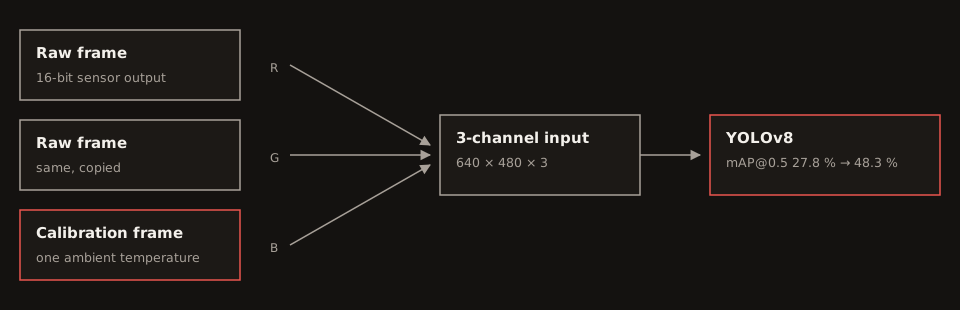
def fuse_channels(raw: np.ndarray, calibration: np.ndarray) -> np.ndarray:
    """A 16-bit raw frame and a calibration frame as one 3-channel input.

    The calibration goes on the third channel: YOLOv8 normalises each channel
    on its own, and that position gave the best results.
    """
    return np.dstack((raw, raw, calibration))  # 640 × 480 × 3
Avec une image de calibration adaptée à chaque image, le modèle atteint 48,3 % sur les images brutes, mieux que la première version sur images corrigées. Pour réduire encore le coût, une seule image de calibration pour tout le jeu de données donne 37 %.
Plus de données
L'augmentation de données intégrée à YOLOv8 n'apportait rien sur ces images. J'ai donc écrit mes propres augmentations avec Torchvision (symétrie, perspective, cisaillement, rotation, translation, mise à l'échelle, CutOut revisité), en recalculant à chaque fois les boîtes de vérité terrain.


J'ai aussi généré des images synthétiques pour le fine-tuning, et testé la détection multiclasse : voitures 78 %, piétons 70 %, deux-roues 35 %, ces derniers étant trop rares dans le jeu de données.
Les résultats
L'évaluation finale compare les cinq tailles de YOLOv8 sur trois jeux de données : images corrigées et tone mappées, images seulement calibrées, et images brutes avec une image de calibration. Environ 10 points séparent le meilleur modèle sur images corrigées du meilleur sur images brutes. La quantification INT8 divise le temps d'inférence par deux à trois pour 5 à 9 points de mAP, et tous les modèles tiennent le temps réel sur GPU, même YOLOv8x à environ 20 images par seconde.

Deux conclusions de l'année précédente sont tombées : le tone mapping n'est plus indispensable, et les images brutes donnent désormais des résultats exploitables. Le modèle généralise aussi hors des données de Lynred : de 81,8 % à 84,0 % de mAP@0.5 sur le jeu public CVC-14. Le code, une note technique et le rapport ont été transmis à la chaire, où un post-doctorant a repris le sujet à la rentrée 2023, avec une piste claire : un modèle multimodal, conçu pour l'infrarouge, qui lit aussi la température du capteur.